
Một người đam mê phần cứng đã tái sử dụng card đồ họa doanh nghiệp cũ để chạy các mô hình ngôn ngữ lớn (LLM) cục bộ, giúp nhân đôi dung lượng VRAM của hệ thống lên 32GB chỉ với chi phí 266 USD.
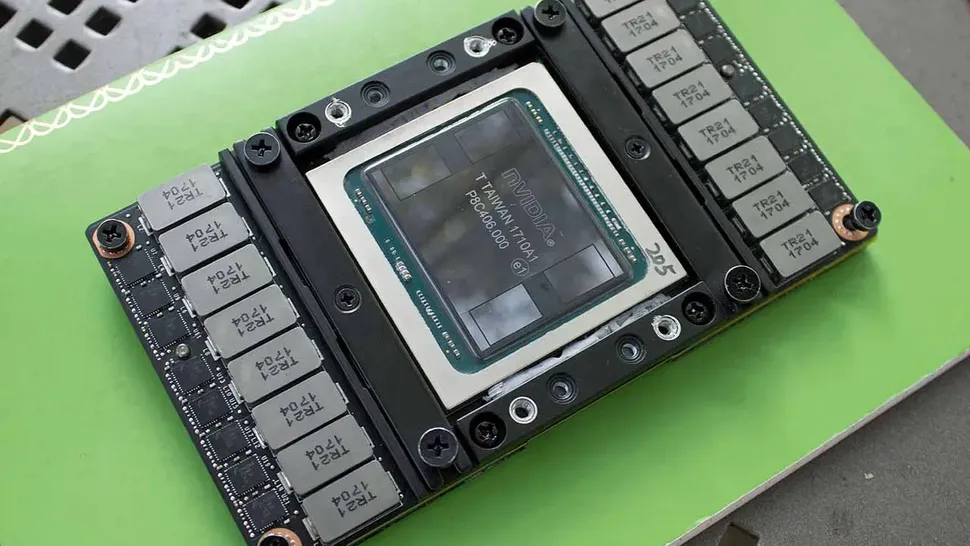
Trong bối cảnh dung lượng bộ nhớ đồ họa ngày càng trở nên đắt đỏ, Oscar Molnar đã tìm mua một chiếc card Nvidia Tesla V100 SXM2 phiên bản 16GB HBM2 cũ với giá dưới 140 USD. Tuy nhiên, việc lắp đặt card doanh nghiệp này vào máy tính cá nhân không hề đơn giản. Molnar đã phải chi thêm khoảng 66 USD để mua một bộ chuyển đổi từ chuẩn kết nối SXM2 sang PCIe.
Thử thách lớn nhất nằm ở hệ thống tản nhiệt nguyên bản của Tesla V100. Chiếc quạt tản nhiệt này tạo ra tiếng ồn lên tới 82dB, được Molnar mô tả là “nằm giữa máy xay rác và máy cắt cỏ”. Để giải quyết vấn đề, anh đã độ lại dây nguồn của quạt để cắm trực tiếp vào chân PWM trên bo mạch chủ. Kết quả là chiếc quạt chỉ cần chạy ở mức 10% công suất là đủ để giữ nhiệt độ của Tesla V100 dưới 50 độ C khi chạy tải nặng, đồng thời loại bỏ hoàn toàn tiếng ồn khó chịu.
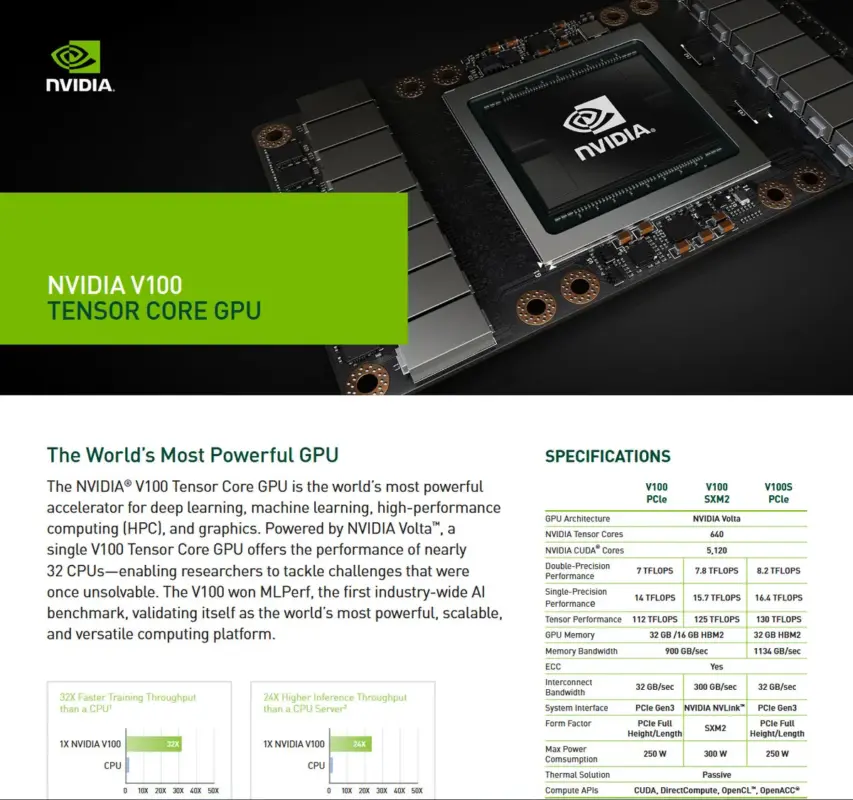
Sau khi hoàn thiện phần cứng, Molnar sở hữu một hệ thống có tổng cộng 32GB VRAM, kết hợp giữa card RTX 4080 16GB (kiến trúc Ada) và Tesla V100 16GB (kiến trúc Volta). Để hệ điều hành nhận diện và sử dụng song song hai kiến trúc khác nhau này, anh đã cài đặt NixOS cùng với trình điều khiển (driver) Nvidia phiên bản cũ hỗ trợ cả hai thế hệ chip.
Về hiệu năng, hệ thống này có thể chạy mượt mà một mô hình ngôn ngữ lớn (LLM) có quy mô 27 tỷ tham số với tốc độ 32 token mỗi giây. Molnar cho biết tốc độ này “đủ nhanh để sử dụng tương tác thực tế” và thậm chí còn nhanh hơn hầu hết các dịch vụ API đám mây trả phí hiện nay. Việc tận dụng linh kiện máy chủ cũ giá rẻ đang trở thành một giải pháp thông minh cho những ai muốn xây dựng hệ thống AI cá nhân mà không cần chi hàng nghìn USD cho các card đồ họa chuyên dụng thế hệ mới.